누구나법률 1장(출발 — 법 앞에 누구나)에서 나온 이야기를 이해하는 데 필요한 개념들을 정리했다. 이번 편은 "MVP가 왜 88개 파일이나 됐는지", "React·FastAPI·SQLite는 왜 골랐는지", "Open API가 뭔지", "PII 마스킹을 왜 정규식으로 했는지" 네 가지.
MVP인데 왜 하루 만에 88개 파일이 나왔나
MVP(Minimum Viable Product)는 원래 "최소 기능 제품"이다. PM 시절에 흔히 쓰던 정의는 "핵심 가설을 검증할 수 있는 가장 작은 버전"이었다. 그런데 누구나법률 1장에서 첫 커밋이 벌써 88개 파일, 19,209줄이었다. 이게 정말 "최소"였을까.
결론부터 말하면 — AI 코딩 도구를 쓰면 "최소"의 기준선 자체가 달라진다. 예전 기준으로 "MVP"라고 하면 로그인도 없이 화면 두세 개 정도였겠지만, 지금은 AI에게 "계약서 업로드하면 위험 조항 분석해주는 서비스 만들어줘"라고 하면 파일 업로드, 텍스트 파싱, LLM 호출, DB 저장까지 한 번에 나온다. 사람이 타이핑하는 속도가 병목이 아니게 되니까, "일단 되는 것만 만들자"의 그 "일단 되는 것"의 범위 자체가 넓어진다.
실무 팁: 그래서 AI로 MVP를 만들 때는 "기능을 줄이는 것"보다 "검증하려는 가설 하나에 집중해서, 그 가설과 무관한 기능은 아예 요청하지 않는 것"이 더 중요한 절제 포인트가 된다. 만들 수 있다고 다 만들면, 정작 검증해야 할 핵심 가설이 부가기능들 사이에 묻힌다.
왜 React + FastAPI + SQLite였나
세 가지 선택 다 "이유가 거창해서"가 아니라 "지금 이 상황에 가장 마찰이 적어서"에 가깝다.
- React — 프론트엔드 생태계에서 제일 자료가 많고, AI 코딩 도구들이 제일 잘 아는 프레임워크다. 뭔가 막히면 AI도 나도 예시를 제일 쉽게 찾는다.
- FastAPI (Python) — LLM 관련 SDK(OpenAI, Anthropic, Groq 등)가 Python 우선으로 나온다. 그리고 FastAPI는 코드에 타입을 붙이면 API 문서(/docs)가 자동으로 생긴다. 백엔드 스펙 문서를 따로 안 써도 된다는 게 1인 개발에선 크다.
- SQLite — 별도 DB 서버를 안 띄워도 파일 하나로 끝난다. "일단 돌아가게" 하는 단계에서 PostgreSQL 세팅까지 갈 이유가 없었다. 나중에 트래픽이 늘면 그때 옮기면 된다 — 실제로 이 프로젝트도 초반엔 SQLite로 시작해서 지금까지 그대로 쓰고 있다(아직 옮길 필요가 없었다는 뜻이기도 하다).
셋의 공통점은 "정답이라서"가 아니라 "막혔을 때 도움을 제일 빨리 받을 수 있는 조합"이라는 것. 1인 개발에서는 이게 생각보다 큰 기준이 된다.
Open API — 공공데이터를 API로 받는다는 것
법제처가 제공하는 "Open API"는 별게 아니라, 정부기관이 자기가 가진 데이터(법령·판례)를 인터넷으로 조회할 수 있게 열어둔 창구다. 웹사이트에서 사람이 검색하듯이, 프로그램이 URL 하나 호출하면 그 결과를 JSON이나 XML로 돌려준다.
실무적으로 알아야 할 건 딱 이 정도다.
- 발급키가 필요하다 — 아무나 무제한으로 못 쓰게, 신청하면 개인별 키(ID)를 준다. 이 키를 요청마다 같이 보내야 한다.
- 서버 IP를 등록해야 하는 경우가 있다 — 법제처처럼 공공기관 API는 "이 IP에서 온 요청만 받겠다"고 미리 등록을 요구하기도 한다. 그래서 호스팅을 옮기면(서버 IP가 바뀌면) API 신청 정보도 같이 갱신해야 한다.
- 무료지만 스펙이 불친절할 수 있다 — 상용 API처럼 문서가 잘 정리돼 있지 않은 경우가 많다. 실제로 이 프로젝트에서도 "띄어쓰기가 검색 연산자로 쓰인다"는 사실을 공식 문서가 아니라 직접 부딪혀보고 알아냈다(이 얘기는 누구나법률 3장에서 자세히 다룬다).
PII 마스킹을 왜 LLM이 아니라 정규식으로 했나
사용자가 올린 계약서엔 이름, 주민번호, 전화번호 같은 개인정보가 그대로 들어있다. 이걸 가리는 방법은 크게 두 가지다.
- AI(LLM)한테 "개인정보 가려줘"라고 시키기 — 유연하지만, 느리고, 비용이 들고, 가끔 놓친다. 그리고 애초에 개인정보를 LLM(외부 서버)에 한 번 보내야 하는 것 자체가 찜찜하다.
- 정규식(regex)으로 패턴 매칭 — "주민번호는 숫자 6자리-숫자 7자리"처럼 형식이 정해진 정보는 규칙만 정확히 짜면 100% 결정론적으로 잡아낸다. 빠르고, 무료고, 외부로 데이터를 보낼 필요도 없다.
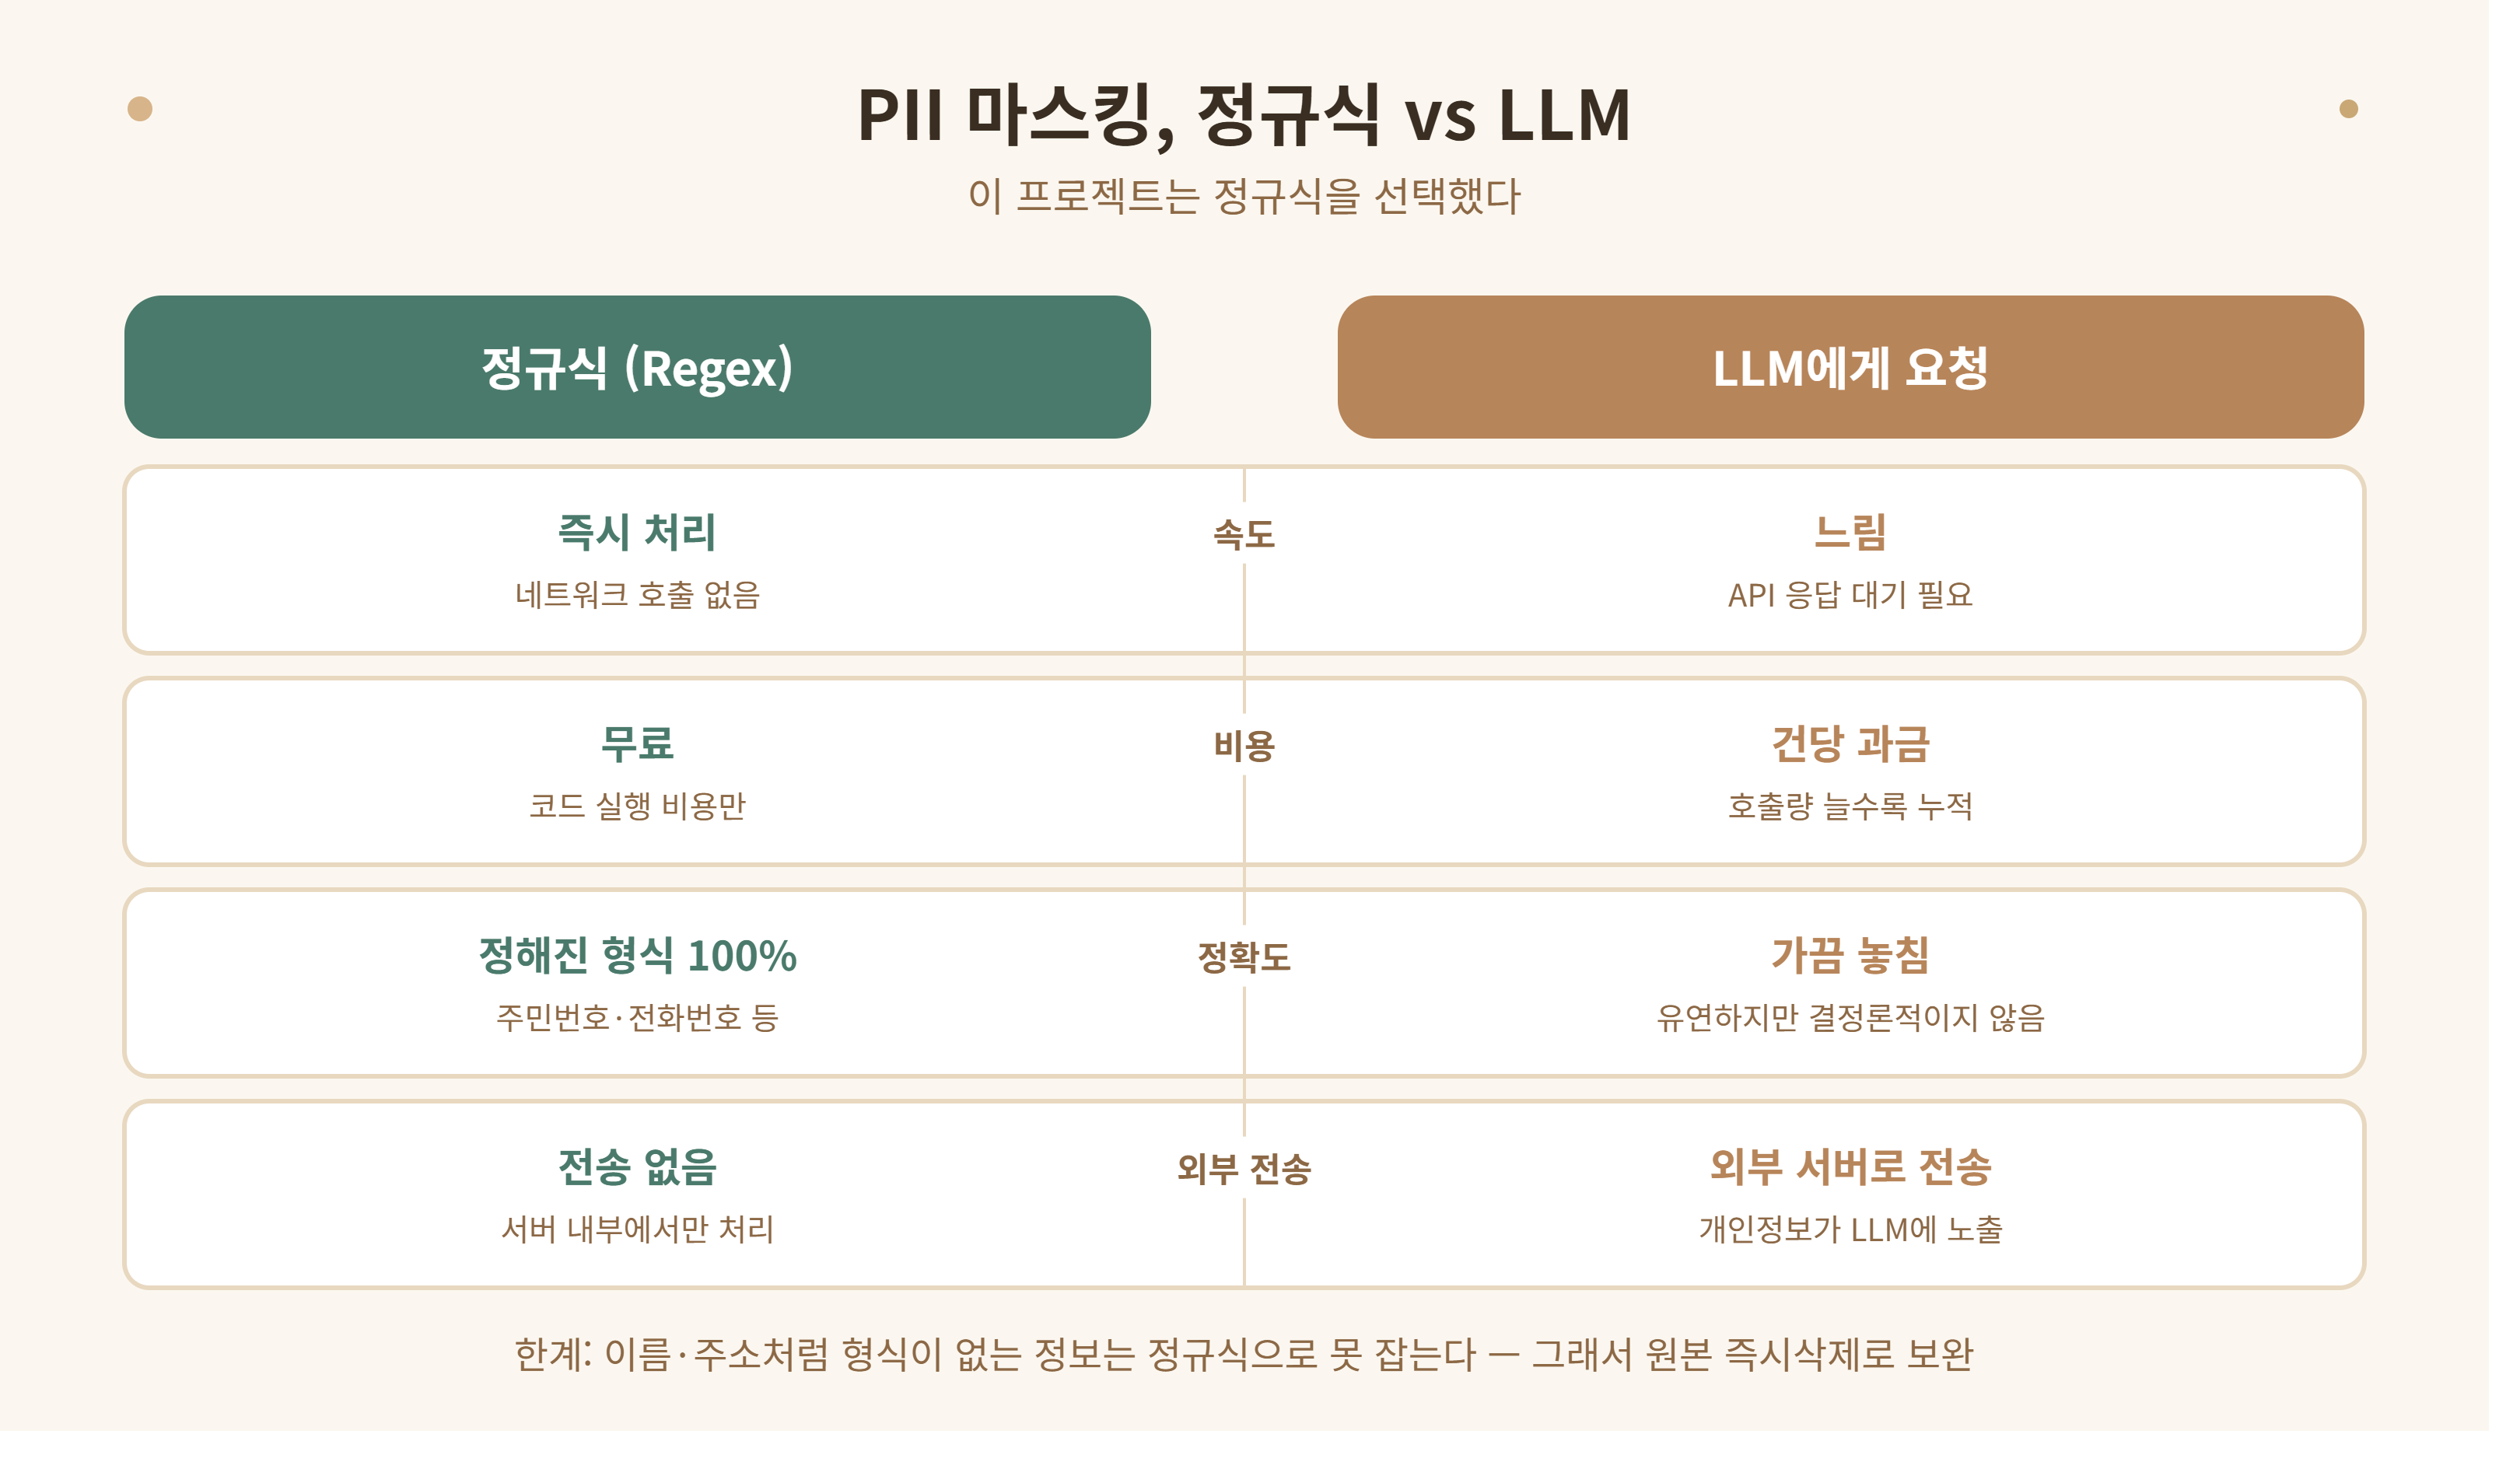
이 프로젝트는 후자를 선택했다. 대신 한계도 명확히 인지하고 있다 — 이름이나 주소처럼 "정해진 형식이 없는" 개인정보는 정규식으로 못 잡는다. 그래서 "이 마스킹은 완벽하지 않다, 원본 파일은 분석 끝나면 바로 지운다"는 이중 안전장치를 같이 넣었다. 하나의 방법으로 완벽을 노리기보다, 각자 잘하는 일만 시키고 부족한 부분은 다른 정책으로 메우는 식이다. AI 프로덕트를 만들 때 자주 마주치는 선택지라 기억해둘 만하다.
다음 실무 사전 편은 누구나법률 2장(돈 문제)이 발행된 후, 그 안에 나오는 개념들(LLM 폴백, SSE·JSON 스트리밍, 무료 호스팅 슬립 이슈)을 정리해서 이어간다.
'AI활용법 > PM의 AI실무' 카테고리의 다른 글
| PM을 위한 AI 실무 사전 6편 — 죽은 API와 의존성 함정 (0) | 2026.08.07 |
|---|---|
| PM을 위한 AI 실무 사전 5편 — PG, CORS, 도메인, OAuth (0) | 2026.08.07 |
| PM을 위한 AI 실무 사전 4편 — 사회적기업 인증과 공모전 생태계 (0) | 2026.08.07 |
| PM을 위한 AI 실무 사전 3편 — RAG, 환각, 그라운딩 (0) | 2026.08.05 |
| PM을 위한 AI 실무 사전 2편 — 폴백 체인, 스트리밍, 콜드 슬립 (0) | 2026.08.04 |